SVD与PCA之间的关系。如何使用SVD执行PCA?


351

通常通过协方差矩阵的特征分解来解释主成分分析(PCA)。但是,它也可以通过数据矩阵奇异值分解(SVD)来执行。它是如何工作的?这两种方法之间有什么联系?SVD和PCA之间是什么关系?X

换句话说,如何使用数据矩阵的SVD进行降维?


8
我用自己的答案写了这个FAQ风格的问题,因为它经常以各种形式被问到,但是没有规范的线索,因此很难关闭重复项。请在此随附的meta线程中提供meta注释。
— 变形虫


2
除了一个出色且详尽的变形虫的答案及其进一步的链接,我可能建议检查一下,其中PCA与其他基于SVD的其他技术并列考虑。那里提出了代数几乎完全相同变形虫与只是微小的差别在讨论该语音存在,在描述PCA,变为约的SVD分解 [或 ]代替 这很方便,因为它与通过协方差矩阵的特征分解完成的PCA有关。 X/ √X/n XX/n−1X
— ttnphns

PCA是SVD的特例。PCA需要标准化的数据,最好是同一单位。在PCA中,矩阵为nxn。
— Orvar Korvar

@OrvarKorvar:您在说什么nxn矩阵?
— Cbhihe

Answers:


411

令数据矩阵为大小,其中是样本数,是变量数。让我们假设它是居中的,即列均值已经减去,现在等于零。 Ñ × p Ñ pXn×pnp

然后协方差矩阵由。它是一个对称矩阵,因此可以对角线化:其中是特征向量的矩阵(每列是一个特征向量),而是对角矩阵,其特征值在对角线上递减。特征向量被称为数据的主轴或主轴方向。数据在主轴上的投影称为主成分,也称为PC分数C ^ C ^ = X ⊤ X /(ñ - 1 )C ^ = V 大号V ⊤,V 大号λ 我 Ĵ Ĵ X V我我X Vp×pCC=X⊤X/(n−1)

C=VLV⊤,
VLλi; 这些可以看作是新的,转换后的变量。第个主成分由第列给出。新的PC空间中第个数据点的坐标由第行给出。jjXViiXV

如果现在执行奇异值分解,我们将获得分解其中是ary矩阵,是对角矩阵奇异值。从这里可以轻松地看到表示右奇异矢量是主要方向,并且奇异值通过与协方差矩阵的特征值相关。主要成分由X = û 小号V ⊤,û 小号小号我Ç = V 小号ü ⊤ ù 小号V ⊤ /(ñ - 1 )= V 小号 2X

X=USV⊤,
USsiVλ我=小号 2 我 /(ñ-1)XV=û小号V⊤V=û小号
C=VSU⊤USV⊤/(n−1)=VS2n−1V⊤,
Vλi=si2/(n−1)XV=USV⊤V=US。

总结一下:

  1. 如果,则主要方向/轴。VX=USV⊤V
  2. 列是主要组成部分(“分数”)。US
  3. 奇异值通过与协方差矩阵的特征值相关。特征值显示各个PC的方差。λ 我λi=si2/(n−1)λi
  4. 标准化分数由列给出,负载由。例如,请参见此处和此处,了解为什么不应将“负载”与主要说明混淆。VS/ √n−1UVS/n−1
  5. 仅当居中时,以上才是正确的。X只有这样,协方差矩阵才等于。X⊤X/(n−1)
  6. 以上仅适用于在行中具有样本而在列中具有变量的情况。如果变量在行中,样本在列中,则和交换解释。ü VXUV
  7. 如果要在相关矩阵(而不是协方差矩阵)上执行PCA,则列不仅应居中,而且也应标准化,即除以它们的标准偏差。X
  8. 要将数据的维数从减小到,请选择前列,并选择的左上部分。他们的乘积是包含前 PC的矩阵。k < p k U k × k S U k S k n × k kpk<pkUk×kSUkSkn×kk
  9. 将前 PC 乘以相应的主轴得出矩阵具有原始 x 的大小,但等级较低(等级)。该矩阵提供了前 PC 的原始数据的重构。它具有尽可能低的重建误差,请在此处查看我的答案。V ⊤ ķ X ķ = û ⊤ ķ小号⊤ ķ V ⊤ ķ Ñ × p ķ X ķ ķkVk⊤Xk=Uk⊤Sk⊤Vk⊤n×pkXkk
  10. 严格来说,的大小是,大小是。但是,如果则的最后列是任意的(并且对应行为常数零);因此应该使用的经济尺寸(或薄返回)SVD的的大小,丢弃所述无用列。对于较大的矩阵否则将不必要地巨大。对于的相反情况也是如此 Ñ × Ñ V p × p Ñ > p ñ - p ü 小号ü Ñ × p Ñ » p ü Ñ « pUn×nVp×pn>pn−pUSUn×pn≫pUn≪p。

其他连结

旋转PCA动画


5
@Antoine,协方差矩阵的定义等于,其中尖括号表示平均值。如果将所有作为行堆叠在一个矩阵,则此表达式等于。如果居中,则简化为。考虑方差;等于。但是,如果(即数据居中),则它只是的平均值。⟨(xi−x¯)(xi−x¯)⊤⟩xiX(X−X¯)(X−X¯)⊤/(n−1)XXX⊤/(n−1)⟨(xi−x¯)2⟩x¯=0xi2
— 变形虫


1
变形虫,我有责任根据您提供的链接添加一个链接。希望您觉得合适。
— ttnphns

2
@amoeba是的,但是为什么要使用它?另外,是否可以对使用相同的分母?问题是我看到公式并尝试理解,如何使用它们?Sλi=si2
— 昏暗的

1
@sera只需转置矩阵并摆脱您的问题。否则,您只会感到困惑。
— 变形虫

22

我写了一个Python&Numpy片段,附有@amoeba的答案,如果对某人有用,我将其留在此处。这些评论大部分来自@amoeba的答案。

import numpy as np
from numpy import linalg as la
np.random.seed(42)


def flip_signs(A, B):
    """
    utility function for resolving the sign ambiguity in SVD
    http://stats.stackexchange.com/q/34396/115202
    """
    signs = np.sign(A) * np.sign(B)
    return A, B * signs


# Let the data matrix X be of n x p size,
# where n is the number of samples and p is the number of variables
n, p = 5, 3
X = np.random.rand(n, p)
# Let us assume that it is centered
X -= np.mean(X, axis=0)

# the p x p covariance matrix
C = np.cov(X, rowvar=False)
print "C = \n", C
# C is a symmetric matrix and so it can be diagonalized:
l, principal_axes = la.eig(C)
# sort results wrt. eigenvalues
idx = l.argsort()[::-1]
l, principal_axes = l[idx], principal_axes[:, idx]
# the eigenvalues in decreasing order
print "l = \n", l
# a matrix of eigenvectors (each column is an eigenvector)
print "V = \n", principal_axes
# projections of X on the principal axes are called principal components
principal_components = X.dot(principal_axes)
print "Y = \n", principal_components

# we now perform singular value decomposition of X
# "economy size" (or "thin") SVD
U, s, Vt = la.svd(X, full_matrices=False)
V = Vt.T
S = np.diag(s)

# 1) then columns of V are principal directions/axes.
assert np.allclose(*flip_signs(V, principal_axes))

# 2) columns of US are principal components
assert np.allclose(*flip_signs(U.dot(S), principal_components))

# 3) singular values are related to the eigenvalues of covariance matrix
assert np.allclose((s ** 2) / (n - 1), l)

# 8) dimensionality reduction
k = 2
PC_k = principal_components[:, 0:k]
US_k = U[:, 0:k].dot(S[0:k, 0:k])
assert np.allclose(*flip_signs(PC_k, US_k))

# 10) we used "economy size" (or "thin") SVD
assert U.shape == (n, p)
assert S.shape == (p, p)
assert V.shape == (p, p)
21

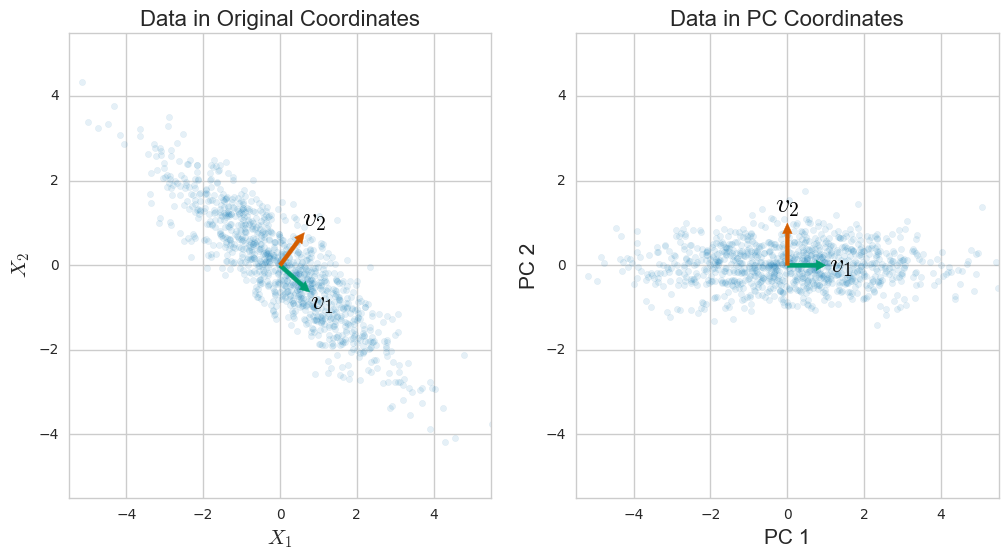
让我从PCA开始。假设您有n个数据点,每个数据点包含d个数字(或维)。如果将此数据居中(从每个数据向量减去平均数据点),则可以堆叠数据以形成矩阵μxi

X=(x1T−μTx2T−μT⋮xnT−μT).

协方差矩阵

S=1n−1∑i=1n(xi−μ)(xi−μ)T=1n−1XTX

度量在不同程度上给出数据的不同坐标。因此,PCA(旨在捕获数据的变化)可以根据协方差矩阵给出,这并不奇怪。特别地,该特征值分解原来是S

S=VΛVT=∑i=1rλiviviT,

其中是第个主成分,即PC,是第个特征值,并且还等于第个PC上数据的方差。这种分解来自线性代数中的一个一般性定理,并且确实需要做一些工作来促使relatino转向PCA。我λ 我我小号我viiλiiSi

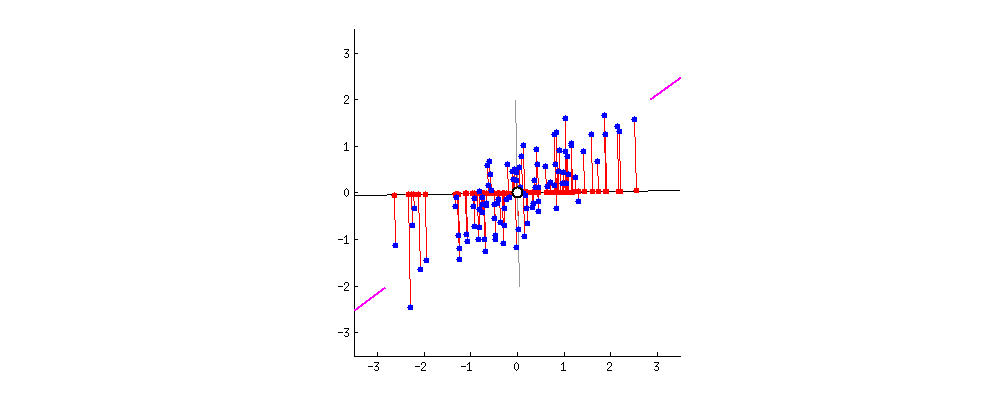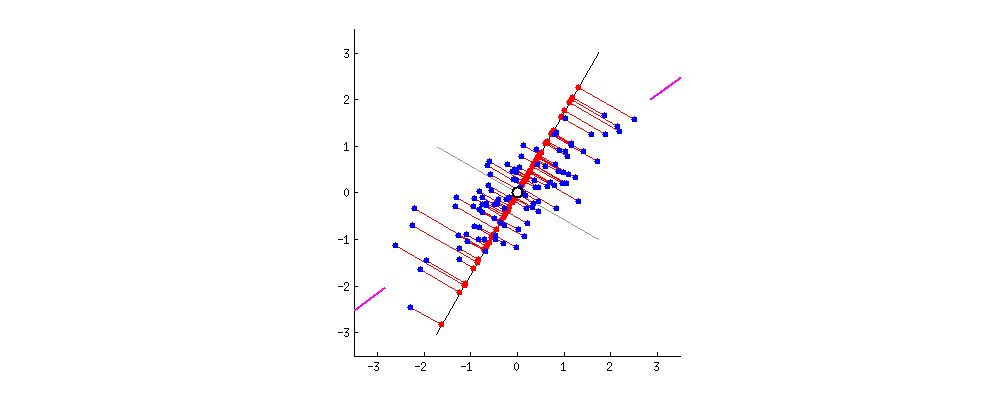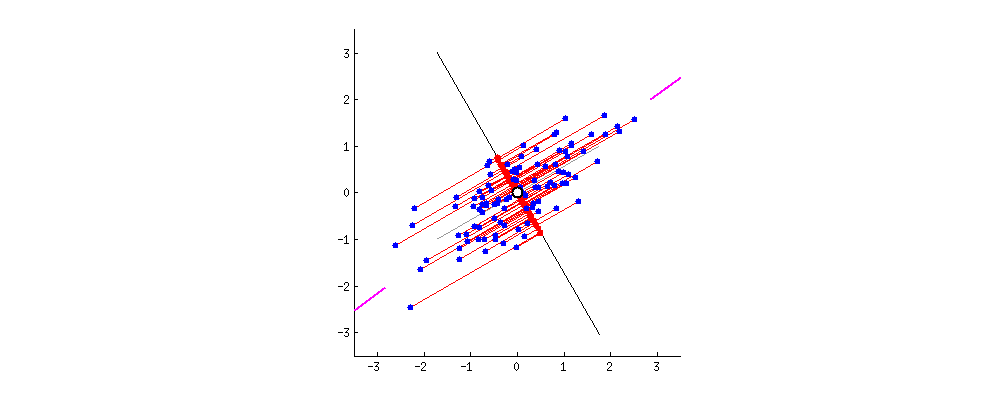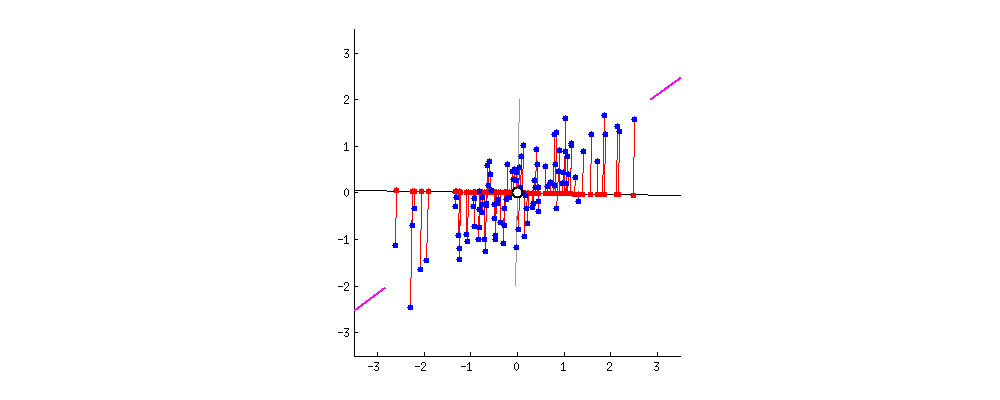
随机生成的高斯数据集的PCA

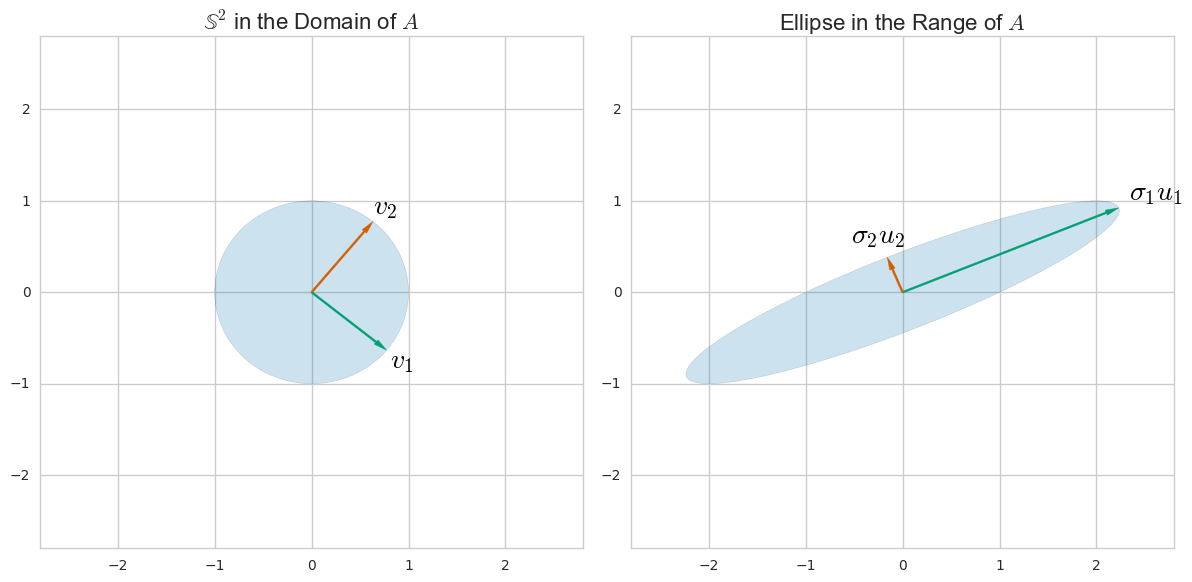
SVD是一种根据矩阵的列空间和行空间来理解矩阵的一般方法。(这是一种以与行和列空间具有直观关系的其他矩阵形式重写任何矩阵的方法。)例如,对于矩阵我们可以在域和范围内找到和方向,以便 u i v iA=(1201)uivi

2x2示例的SVD

ASuivi

XA=X

X=∑i=1rσiuivjT,

{ui}{vi}Svi

ui=1(n−1)λiXvi,

和“奇异值”以下方式与数据矩阵相关σi

σi2=(n−1)λi.

通常的事实是,右奇异向量跨越的列空间。在这种特定情况下,给我们数据在第个主分量方向上的缩放投影。左奇异向量通常跨越的行空间,这给了我们一组正交向量,它们像PC一样跨数据。 X ü 我 X 我v 我 XuiXuiXiviX

在这篇较长的文章中,我将探讨PCA和SVD之间关系的更多细节和好处。


感谢您的回答安德烈。只是两个小的错字校正:1.在最后一段中,您左右混淆。2.在X的(大写)公式中,您使用的是v_j而不是v_i。
— 阿隆
By using our site, you acknowledge that you have read and understand our Cookie Policy and Privacy Policy.
Licensed under cc by-sa 3.0 with attribution required.